Shorts Junior vs Senior - 19 dicas de Django
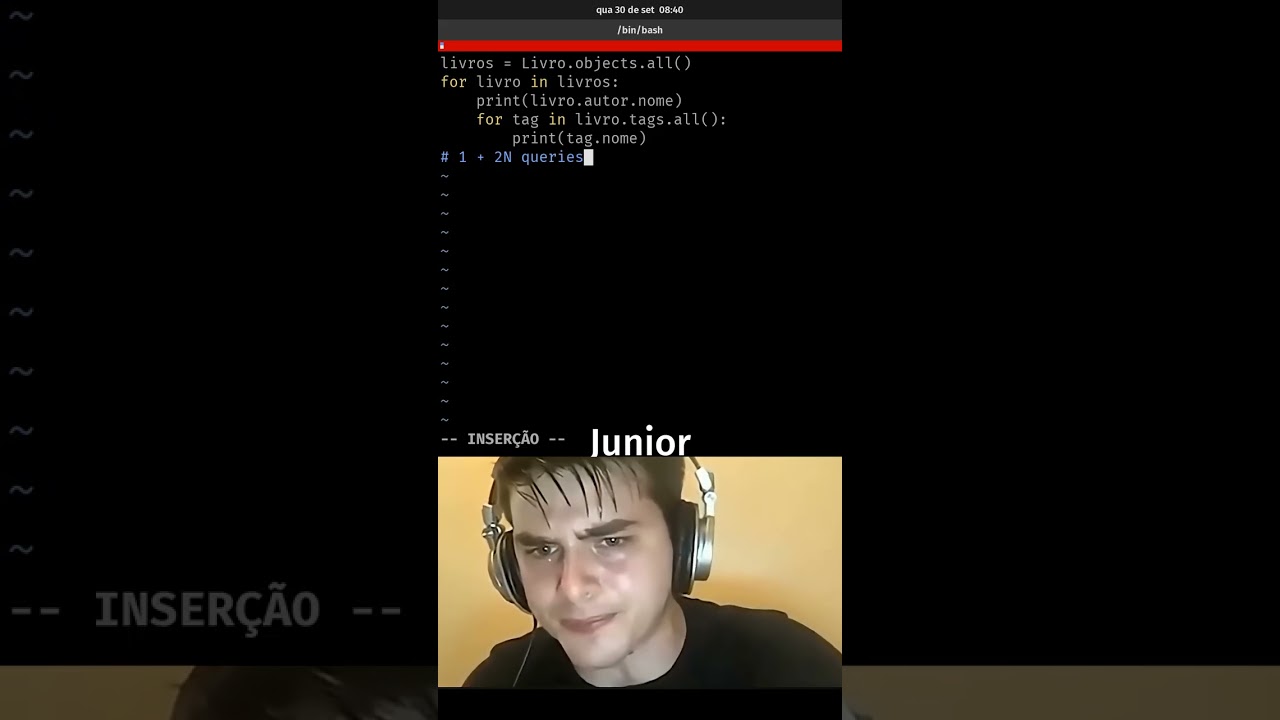
Testado com: Django 6.1; cada dica diz em que versão o recurso apareceu.
Série de shorts no estilo "Junior vs Senior": o jeito do Junior em cima, o do Senior embaixo. Um short a cada três dias. Os que ainda não saíram já estão agendados para a data indicada.
| Data | Short |
|---|---|
| 01/10/2026 | 01. select_related vs prefetch_related |
| 04/10/2026 | 02. only() e defer() |
| 07/10/2026 | 03. F() e condição de corrida |
| 10/10/2026 | 04. bulk_create: de 1000 queries para 1 |
| 13/10/2026 | 05. exists() em vez de count() |
| 16/10/2026 | 06. get_or_create e update_or_create |
| 19/10/2026 | 07. annotate: relatório sem loop |
| 22/10/2026 | 08. iterator(): milhões de linhas sem estourar a memória |
| 25/10/2026 | 09. TextChoices com enum |
| 28/10/2026 | 10. UniqueConstraint e CheckConstraint |
| 31/10/2026 | 11. db_default e GeneratedField |
| 03/11/2026 | 12. Model abstrato com created/modified |
| 06/11/2026 | 13. Manager customizado |
| 09/11/2026 | 14. SECRET_KEY fora do código |
| 12/11/2026 | 15. transaction.atomic: tudo ou nada |
| 15/11/2026 | 16. transaction.on_commit |
| 18/11/2026 | 17. LoginRequiredMiddleware do Django 5.1 |
| 21/11/2026 | 18. squashmigrations: 80 migrations em 1 |
| 24/11/2026 | 19. Admin mais rápido em 3 linhas |
Por tema
- ORM e desempenho: select_related/prefetch_related, only/defer, F(), bulk_create, exists, get_or_create, annotate, iterator.
- Models: TextChoices, constraints, db_default e GeneratedField, model abstrato, manager customizado.
- Segurança e produção: SECRET_KEY fora do código, transaction.atomic, transaction.on_commit.
- Produtividade: LoginRequiredMiddleware, squashmigrations, admin em 3 linhas.
Como ler esta página
Cada dica abaixo tem quatro partes: o problema, o código do Junior (o jeito que funciona, mas cobra caro depois), o código do Senior e a explicação do porquê. Os exemplos usam models de uma loja e de uma livraria (Livro, Autor, Tag, Cliente, Produto, Pedido...). Não é um projeto pronto: são trechos para você adaptar ao seu.
Para conferir as dicas de ORM na prática, rode os exemplos no python manage.py shell e conte as consultas. Um jeito simples, sem instalar nada:
# no python manage.py shell
from django.db import connection
from django.test.utils import CaptureQueriesContext

with CaptureQueriesContext(connection) as ctx:
    ...  # o código que você quer medir

print(len(ctx.captured_queries))
for q in ctx.captured_queries:
    print(q['sql'])
Documentação de apoio:
- Otimização de acesso ao banco: https://docs.djangoproject.com/en/6.1/topics/db/optimization/
- Referência de QuerySet: https://docs.djangoproject.com/en/6.1/ref/models/querysets/
- Transações: https://docs.djangoproject.com/en/6.1/topics/db/transactions/
- Constraints: https://docs.djangoproject.com/en/6.1/ref/models/constraints/
01. select_related vs prefetch_related
O problema: o famoso N+1. Você busca uma lista de livros e, dentro do loop, acessa o autor (uma ForeignKey) e as tags (um ManyToManyField). Cada acesso desses vai ao banco.
Junior:
# views.py
livros = Livro.objects.all()
for livro in livros:
    print(livro.autor.nome)
    for tag in livro.tags.all():
        print(tag.nome)
# 1 + 2N queries
Senior:
# views.py
livros = (
    Livro.objects
    # ForeignKey: resolve com JOIN
    .select_related('autor')
    # ManyToMany: só 1 query a mais
    .prefetch_related('tags')
)
for livro in livros:
    print(livro.autor.nome)
    for tag in livro.tags.all():
        print(tag.nome)
# 2 queries, com 10 ou 10 mil livros
Explicação: no código do Junior, a primeira query traz os livros; depois, para cada livro, livro.autor faz uma query e livro.tags.all() faz outra. Com 100 livros são 201 queries.
select_related('autor')serve para relações que apontam para um objeto (ForeignKeyeOneToOneField). O Django faz umJOINe traz o autor na mesma query do livro.prefetch_related('tags')serve para relações que trazem muitos objetos (ManyToManyFielde o lado reverso de umaForeignKey). O Django faz uma segunda query comWHERE livro_id IN (...)e monta as listas em Python.
Resultado: 2 queries, não importa quantos livros existam.
02. only() e defer()
O problema: o Cliente tem uma bio enorme e uma foto em base64 no banco, mas a tela só mostra nome e e-mail. Mesmo assim, o SELECT traz todas as colunas.
Junior:
# views.py
clientes = Cliente.objects.all()
for c in clientes:
    print(c.nome, c.email)
# SELECT * : traz a bio de 1 MB
# e a foto em base64 junto
Senior:
# views.py
clientes = Cliente.objects.only(
    'nome', 'email',
)
for c in clientes:
    print(c.nome, c.email)
# SELECT só das colunas que você usa

# ou o contrário: tudo menos a bio
Cliente.objects.defer('bio', 'foto')

# cuidado: ler c.bio depois
# faz outra query por objeto
Explicação: only() diz quais colunas buscar (a chave primária vem sempre); defer() diz quais deixar de fora. Os objetos continuam sendo instâncias de Cliente, mas os campos adiados só são carregados se você acessá-los, e aí cada acesso é uma query nova. Use quando você sabe exatamente o que a tela precisa. Se precisar só dos valores, e não de objetos, values('nome', 'email') também resolve.
03. F() e condição de corrida
O problema: baixar o estoque lendo o valor em Python e gravando de volta. Se duas vendas acontecem ao mesmo tempo, as duas leem o mesmo número.
Junior:
# views.py
produto = Produto.objects.get(pk=1)
produto.estoque = produto.estoque - 1
produto.save()
# 2 vendas ao mesmo tempo:
# as duas leem 10 e gravam 9
Senior:
# views.py
from django.db.models import F

Produto.objects.filter(pk=1).update(
    estoque=F('estoque') - 1,
)
# UPDATE ... SET estoque = estoque - 1
# quem faz a conta é o banco:
# sem condição de corrida
Explicação: no código do Junior existem dois passos separados (ler e gravar), e entre eles outra requisição pode ler o valor antigo. Duas vendas, estoque 10, resultado 9: uma venda sumiu. F('estoque') é uma referência à coluna no banco. O update() vira um único UPDATE ... SET estoque = estoque - 1, e o banco garante que cada operação parte do valor atual. Bônus: é uma query só, sem o SELECT antes.
Se você precisar do objeto atualizado depois, use produto.refresh_from_db().
04. bulk_create: de 1000 queries para 1
O problema: importar uma planilha criando um registro por vez.
Junior:
# importar.py
for linha in planilha:
    Produto.objects.create(
        nome=linha['nome'],
        preco=linha['preco'],
    )
# 1000 linhas = 1000 INSERTs
Senior:
# importar.py
produtos = [
    Produto(
        nome=linha['nome'],
        preco=linha['preco'],
    )
    for linha in planilha
]
Produto.objects.bulk_create(produtos)
# 1000 linhas = 1 INSERT

for p in produtos:
    p.ativo = False
Produto.objects.bulk_update(
    produtos, ['ativo'],
)
Explicação: create() faz um INSERT por chamada, com uma ida e volta ao banco cada. bulk_create() recebe uma lista de objetos (ainda não salvos) e faz um INSERT com várias linhas. Para alterar muitos objetos de uma vez, bulk_update() recebe os objetos e a lista de campos a gravar.
Cuidados: bulk_create não chama o save() do model nem dispara os sinais pre_save e post_save. Para listas muito grandes, passe batch_size (por exemplo, bulk_create(produtos, batch_size=500)) para dividir em lotes.
05. exists() em vez de count()
O problema: saber se o cliente tem algum pedido.
Junior:
# views.py
pedidos = Pedido.objects.filter(
    cliente=cliente,
)
if pedidos.count() > 0:  # COUNT(*)
    ...
if pedidos:  # carrega TODOS os pedidos
    ...
Senior:
# views.py
pedidos = Pedido.objects.filter(
    cliente=cliente,
)
if pedidos.exists():
    ...
# SELECT 1 ... LIMIT 1
# para no primeiro que encontrar
Explicação: count() faz o banco contar todas as linhas, e if pedidos: é pior ainda: avalia o QuerySet e traz todos os pedidos para a memória só para saber se a lista está vazia. exists() gera um SELECT 1 ... LIMIT 1, que para no primeiro registro encontrado.
A exceção: se você vai usar os pedidos logo depois (por exemplo, num loop), avaliar o QuerySet uma vez com if pedidos: reaproveita o cache e evita uma segunda query.
06. get_or_create e update_or_create
O problema: "busca; se não existir, cria" e "se existir, atualiza; senão, cria", escritos na mão.
Junior:
# views.py
try:
    tag = Tag.objects.get(nome='orm')
except Tag.DoesNotExist:
    tag = Tag.objects.create(nome='orm')

cliente = Cliente.objects.filter(
    email=email,
).first()
if cliente:
    cliente.nome = nome
    cliente.save()
else:
    Cliente.objects.create(
        email=email, nome=nome,
    )
Senior:
# views.py
tag, criada = Tag.objects.get_or_create(
    nome='orm',
)

cliente, criado = (
    Cliente.objects.update_or_create(
        email=email,
        defaults={'nome': nome},
    )
)
Explicação: os dois métodos devolvem uma tupla (objeto, criado), em que criado é True quando o registro foi criado agora.
get_or_create(nome='orm')busca pelos argumentos; se não achar, cria com eles.update_or_create(email=email, defaults={...})busca pelos argumentos de busca (email) e aplica odefaults(atualizando ou criando).
Além de menos código, o Django trata a corrida entre duas requisições criando o mesmo registro: se o INSERT falhar por violar uma restrição de unicidade, ele tenta buscar de novo. Para isso funcionar, o campo de busca precisa ser unique no banco.
07. annotate: relatório sem loop
O problema: total de vendas por autor, somando em Python.
Junior:
# relatorios.py
relatorio = []
for autor in Autor.objects.all():
    total = 0
    for livro in autor.livro_set.all():
        total += livro.vendas
    relatorio.append((autor.nome, total))
# N queries e a soma feita em Python
Senior:
# relatorios.py
from django.db.models import Count, Sum

relatorio = Autor.objects.annotate(
    livros=Count('livro'),
    vendas=Sum('livro__vendas'),
).order_by('-vendas')

for autor in relatorio:
    print(autor.nome, autor.vendas)
# 1 query com GROUP BY
Explicação: annotate() adiciona a cada autor um campo calculado pelo banco. Count('livro') conta os livros relacionados e Sum('livro__vendas') soma a coluna vendas deles. O SQL vira um único SELECT ... GROUP BY, e o resultado já pode ser ordenado e filtrado pelo campo novo (.order_by('-vendas'), .filter(vendas__gt=1000)).
Atenção: um autor sem livros recebe vendas = None na soma. Se preferir zero, use Coalesce(Sum('livro__vendas'), 0) (de django.db.models.functions).
08. iterator(): milhões de linhas sem estourar a memória
O problema: processar uma tabela de logs com milhões de linhas.
Junior:
# tarefas.py
for log in Log.objects.all():
    processar(log)
# 5 milhões de objetos na memória:
# o QuerySet guarda tudo em cache
Senior:
# tarefas.py
logs = Log.objects.all()
for log in logs.iterator(chunk_size=2000):
    processar(log)
# busca de 2000 em 2000
# e não guarda cache:
# a memória fica estável
Explicação: quando você percorre um QuerySet, o Django guarda todos os objetos no cache dele (para que um segundo loop não vá ao banco de novo). Com milhões de linhas, isso estoura a memória. iterator() desliga esse cache e lê os resultados em lotes de chunk_size. No PostgreSQL ele usa um cursor do lado do servidor, então só o lote atual fica na memória.
Combina bem com only() (dica 02) para trazer menos colunas por linha.
09. TextChoices com enum
O problema: choices como tupla de letras soltas. No meio do código, ninguém lembra o que é 'E'.
Junior:
# models.py
STATUS = (
    ('P', 'Pendente'),
    ('E', 'Enviado'),
)

class Pedido(models.Model):
    status = models.CharField(
        max_length=1, choices=STATUS,
    )

Pedido.objects.filter(status='E')
# 'E' de quê mesmo?
Senior:
# models.py
class Pedido(models.Model):
    class Status(models.TextChoices):
        PENDENTE = 'P', 'Pendente'
        ENVIADO = 'E', 'Enviado'

    status = models.CharField(
        max_length=1,
        choices=Status,
        default=Status.PENDENTE,
    )

Pedido.objects.filter(
    status=Pedido.Status.ENVIADO,
)
pedido.get_status_display()  # 'Enviado'
Explicação: TextChoices é um enum: cada membro tem o valor gravado no banco ('P') e o rótulo para humanos ('Pendente'). No código você escreve Pedido.Status.ENVIADO, o editor completa, e um erro de digitação vira AttributeError em vez de um filtro que não acha nada. Desde o Django 5.0 você pode passar a classe direto em choices=Status (sem .choices). O get_status_display() continua funcionando. Para números, existe o IntegerChoices.
10. UniqueConstraint e CheckConstraint
O problema: colocar as regras de negócio só no save().
Junior:
# models.py
class Reserva(models.Model):
    sala = models.ForeignKey(
        Sala, on_delete=models.CASCADE,
    )
    dia = models.DateField()
    vagas = models.IntegerField()

    def save(self, *args, **kwargs):
        if self.vagas < 0:
            raise ValueError('vagas < 0')
        super().save(*args, **kwargs)
# e o update()? e o bulk_create()?
Senior:
# models.py
from django.db.models import Q

class Reserva(models.Model):
    ...
    class Meta:
        constraints = [
            models.UniqueConstraint(
                fields=['sala', 'dia'],
                name='uma_reserva_por_dia',
            ),
            models.CheckConstraint(
                condition=Q(vagas__gte=0),
                name='vagas_nao_negativas',
            ),
        ]
# a regra vale até fora do Django
Explicação: o save() não é chamado por QuerySet.update(), por bulk_create(), por um script SQL ou por outro sistema que acessa o mesmo banco. Constraints viram regras do próprio banco (criadas pela migration):
UniqueConstraint(fields=['sala', 'dia']): não pode haver duas reservas da mesma sala no mesmo dia.CheckConstraint(condition=Q(vagas__gte=0)): o banco recusa vagas negativas. O argumento se chamaconditiondesde o Django 5.1 (antes eracheck).
Quem tentar burlar recebe um IntegrityError. E nos formulários (ModelForm), o Django valida as constraints no full_clean(), mostrando o erro para o usuário antes de chegar ao banco.
11. db_default e GeneratedField
O problema: valor padrão que só existe no Python, e um total calculado numa @property, que não dá para usar em filtros.
Junior:
# models.py
class Item(models.Model):
    criado = models.DateTimeField(
        default=timezone.now,
    )
    preco = models.IntegerField()
    qtd = models.IntegerField()

    @property
    def total(self):
        return self.preco * self.qtd
# total não dá para filtrar no banco
Senior:
# models.py
from django.db.models import F
from django.db.models.functions import Now

class Item(models.Model):
    criado = models.DateTimeField(
        db_default=Now(),
    )
    preco = models.IntegerField()
    qtd = models.IntegerField()
    total = models.GeneratedField(
        expression=F('preco') * F('qtd'),
        output_field=models.IntegerField(),
        db_persist=True,
    )

Item.objects.filter(total__gt=1000)
Explicação: os dois recursos chegaram no Django 5.0.
db_default=Now()cria o valor padrão no banco (DEFAULT now()). UmINSERTfeito fora do Django também ganha a data.GeneratedFieldé uma coluna calculada pelo banco a partir de outras.db_persist=Truegrava o valor em disco (coluna "stored"), atualizado sempre queprecoouqtdmudam. Como é uma coluna de verdade, você filtra, ordena e indexa por ela:Item.objects.filter(total__gt=1000).
Observação: o valor do GeneratedField é calculado pelo banco, não pelo Python. Se você alterar preco em um objeto e salvar, use refresh_from_db() para ler o total novo com segurança.
12. Model abstrato com created/modified
O problema: os mesmos campos de data copiados em todo model.
Junior:
# models.py
class Cliente(models.Model):
    nome = models.CharField(max_length=80)
    criado = models.DateTimeField(
        auto_now_add=True)
    alterado = models.DateTimeField(
        auto_now=True)

class Pedido(models.Model):
    total = models.IntegerField()
    criado = models.DateTimeField(
        auto_now_add=True)
    alterado = models.DateTimeField(
        auto_now=True)
# copiado em todo model...
Senior:
# models.py
class TimeStampedModel(models.Model):
    criado = models.DateTimeField(
        auto_now_add=True)
    alterado = models.DateTimeField(
        auto_now=True)

    class Meta:
        abstract = True

class Cliente(TimeStampedModel):
    nome = models.CharField(max_length=80)

class Pedido(TimeStampedModel):
    total = models.IntegerField()
# abstract: não vira tabela
Explicação: com abstract = True na Meta, o TimeStampedModel não cria tabela. Quem herda dele ganha os campos criado e alterado na própria tabela, sem JOIN nenhum. auto_now_add=True grava a data na criação; auto_now=True grava a data a cada save(). Se um dia você quiser adicionar um campo em todos os models (um ativo, por exemplo), muda em um lugar só. O ideal é colocar esses models numa app core.
13. Manager customizado
O problema: o mesmo filtro de "livros publicados" repetido em várias views.
Junior:
# models.py
livros = Livro.objects.filter(
    publicado=True,
    data__lte=timezone.now(),
)
# o mesmo filtro repetido em 12 views
Senior:
# models.py
class PublicadosManager(models.Manager):
    def get_queryset(self):
        qs = super().get_queryset()
        return qs.filter(
            publicado=True,
            data__lte=timezone.now(),
        )

class Livro(models.Model):
    ...
    objects = models.Manager()
    publicados = PublicadosManager()

Livro.publicados.all()
Livro.publicados.filter(autor=autor)
Explicação: o manager é o ponto de entrada das consultas (Livro.objects). Sobrescrevendo get_queryset(), o Livro.publicados já começa filtrado, e você continua encadeando .filter(), .order_by() etc. A regra de "o que é publicado" fica em um lugar só.
Repare que objects = models.Manager() foi declarado primeiro: o primeiro manager da classe vira o padrão (usado pelo admin e por relações). Se o PublicadosManager fosse o primeiro, o admin esconderia os rascunhos.
Uma alternativa é um QuerySet customizado com métodos (Livro.objects.publicados()), usando QuerySet.as_manager(), que permite encadear filtros nomeados.
14. SECRET_KEY fora do código
O problema: chave secreta e senha do banco escritas no settings.py, que vai para o git.
Junior:
# settings.py
SECRET_KEY = 'django-insecure-q7#m$2x9'
DEBUG = True
DATABASES = {
    'default': {
        'PASSWORD': 'senha123',
    }
}
# git push... e foi tudo pro GitHub
Senior:
# settings.py
from decouple import Csv, config

SECRET_KEY = config('SECRET_KEY')
DEBUG = config('DEBUG', cast=bool)
ALLOWED_HOSTS = config(
    'ALLOWED_HOSTS', cast=Csv(),
)

# .env (e o .env no .gitignore)
# SECRET_KEY=gere-uma-chave-nova
# DEBUG=False
# ALLOWED_HOSTS=meusite.com.br
Explicação: o python-decouple (uv add python-decouple) lê os valores de um arquivo .env ou das variáveis de ambiente. O código vai para o git; o .env não (coloque-o no .gitignore). Cada ambiente tem o seu .env, e o mesmo settings.py serve para desenvolvimento e produção.
cast=boolconverte"False"emFalse(sem isso, a string"False"seria verdadeira).Csv()convertea.com,b.comem lista.
Para gerar uma chave nova:
python -c "from django.core.management.utils import get_random_secret_key; print(get_random_secret_key())"
Se uma chave já foi parar no GitHub, apagar o commit não basta: troque a chave.
15. transaction.atomic: tudo ou nada
O problema: uma transferência entre contas em dois save() separados. Se der erro no meio, o dinheiro sai de uma conta e não chega na outra.
Junior:
# services.py
def transferir(origem, destino, valor):
    origem.saldo -= valor
    origem.save()
    # se der erro aqui...
    destino.saldo += valor
    destino.save()
# ...o dinheiro some
Senior:
# services.py
from django.db import transaction

@transaction.atomic
def transferir(origem, destino, valor):
    origem.saldo -= valor
    origem.save()
    destino.saldo += valor
    destino.save()
# deu erro? ROLLBACK de tudo

# ou só num trecho:
with transaction.atomic():
    ...
Explicação: por padrão o Django está em modo autocommit: cada save() é confirmado na hora. transaction.atomic abre uma transação; se o bloco termina normalmente, faz COMMIT; se uma exceção escapa do bloco, faz ROLLBACK e nada do que foi feito dentro dele fica gravado. Pode ser usado como decorador (a função inteira) ou como with (só um trecho).
Atenção: não capture a exceção dentro do bloco atômico só para seguir em frente; o Django precisa ver a exceção para desfazer. Para o caso de saldo, combine com a dica 03 (F()) ou com select_for_update() para evitar a condição de corrida.
16. transaction.on_commit
O problema: mandar um e-mail dentro de uma transação. Se algo falha depois, o banco desfaz tudo, mas o e-mail já saiu.
Junior:
# services.py
@transaction.atomic
def criar_pedido(dados):
    p = Pedido.objects.create(**dados)
    enviar_email(p)
    baixar_estoque(p)  # deu erro!
# ROLLBACK... mas o e-mail já foi
Senior:
# services.py
from functools import partial

@transaction.atomic
def criar_pedido(dados):
    p = Pedido.objects.create(**dados)
    baixar_estoque(p)
    transaction.on_commit(
        partial(enviar_email, p),
    )
# o e-mail só sai depois do COMMIT
# deu ROLLBACK? não envia nada
Explicação: e-mail, chamada de API e tarefa no Celery são efeitos fora do banco: o ROLLBACK não consegue desfazê-los. transaction.on_commit(funcao) registra uma função para rodar depois do COMMIT. Se a transação for desfeita, a função é descartada. Ela recebe uma função sem argumentos, por isso o partial(enviar_email, p) (uma lambda: enviar_email(p) também serve).
Esse cuidado é ainda mais importante com Celery: se a tarefa for enfileirada antes do commit, o worker pode procurar o pedido no banco antes de ele existir.
17. LoginRequiredMiddleware do Django 5.1
O problema: proteger view por view com @login_required e LoginRequiredMixin. Basta esquecer uma para ela ficar aberta.
Junior:
# views.py
@login_required
def painel(request): ...

@login_required
def relatorio(request): ...

class PedidoList(LoginRequiredMixin,
                 ListView): ...

def financeiro(request): ...
# esqueceu em uma? ficou aberta
Senior:
# settings.py (Django 5.1+)
MIDDLEWARE = [
    # ... os middlewares de sempre
    'django.contrib.auth.middleware'
    '.LoginRequiredMiddleware',
]

# views.py: marque só as públicas
from django.contrib.auth.decorators import (
    login_not_required,
)

@login_not_required
def home(request): ...
Explicação: o Django 5.1 inverteu a lógica com o LoginRequiredMiddleware: todas as views passam a exigir login, e você marca as exceções com @login_not_required. Esquecer agora é seguro: a view esquecida fica fechada, não aberta.
Detalhes:
- As duas strings
'django.contrib.auth.middleware' '.LoginRequiredMiddleware'são concatenadas pelo Python; é só para caber na tela. Escreva'django.contrib.auth.middleware.LoginRequiredMiddleware'. - O middleware precisa vir depois do
AuthenticationMiddleware. - A
LoginViewdo Django já vem marcada como pública. As views do admin têm o próprio controle. - Quem não está logado é redirecionado para o
LOGIN_URL.
18. squashmigrations: 80 migrations em 1
O problema: uma app com 80 migrations, a maioria alterando o mesmo campo. Cada migrate em banco novo (inclusive nos testes) aplica uma por uma.
Junior:
$ ls loja/migrations/ | tail -4
0077_alter_produto_nome.py
0078_alter_produto_nome.py
0079_alter_produto_nome.py
0080_alter_produto_nome.py
$ ls loja/migrations/*.py | wc -l
      81
Senior:
$ python manage.py squashmigrations loja 0080
Will squash the following migrations:
 - 0001_initial
 - 0002_produto_preco_alter_produto_nome
 - 0003_alter_produto_nome
 ...
 - 0079_alter_produto_nome
 - 0080_alter_produto_nome
Optimizing...
  Optimized from 88 operations to 1 operations.
Created new squashed migration /home/rg3915/loja/loja/migrations/0001_squashed_0080_alter_produto_nome.py
  You should commit this migration but leave the old ones in place;
  the new migration will be used for new installs. Once you are sure
  all instances of the codebase have applied the migrations you squashed,
  you can delete them.
Explicação: squashmigrations loja 0080 junta as migrations da 0001 até a 0080 em uma só e otimiza as operações: 88 operações (criar o model, adicionar campos, alterar o nome dezenas de vezes) viraram 1 CreateModel já com o estado final.
A migration nova tem um atributo replaces com a lista das antigas. O processo seguro é:
- Rode o
squashmigrationse faça commit da migration nova mantendo as antigas. Bancos novos aplicam só a squashed; bancos existentes, que já aplicaram as antigas, apenas a marcam como aplicada. - Depois que todos os ambientes (produção, homologação, máquinas da equipe) tiverem rodado o
migrate, apague as migrations antigas e remova oreplacesda squashed.
Se alguma migration tiver RunPython, revise a squashed antes do commit: o otimizador não consegue juntar operações que passam por código Python.
19. Admin mais rápido em 3 linhas
O problema: o admin de livros faz uma query por autor na listagem e, no formulário, monta um <select> com 50 mil autores.
Junior:
# admin.py
@admin.register(Livro)
class LivroAdmin(admin.ModelAdmin):
    list_display = ['titulo', 'autor']
# lista: 1 query por autor
# form: <select> com 50 mil autores
# e nenhuma busca
Senior:
# admin.py
@admin.register(Livro)
class LivroAdmin(admin.ModelAdmin):
    list_display = ['titulo', 'autor']
    list_select_related = ['autor']
    autocomplete_fields = ['autor']
    search_fields = ['titulo']

@admin.register(Autor)
class AutorAdmin(admin.ModelAdmin):
    search_fields = ['nome']
# o autocomplete precisa do
# search_fields no admin do Autor
Explicação: as três linhas novas:
list_select_related = ['autor']: a listagem faz umselect_related('autor')(a dica 01, dentro do admin), e as 100 linhas da página saem em uma query.autocomplete_fields = ['autor']: troca o<select>gigante por um campo com busca, que carrega os autores por AJAX conforme você digita.search_fields = ['titulo']: adiciona a caixa de busca na listagem de livros.
O autocomplete_fields exige que o admin do model relacionado (AutorAdmin) tenha search_fields, porque é ali que a busca acontece. Sem isso, o Django acusa um erro no check ao iniciar.
Fechamento
O padrão se repete nas 19 dicas: o código do Junior funciona com dez registros na sua máquina, e o do Senior continua funcionando com milhões de registros, com duas requisições ao mesmo tempo e com um erro no meio do caminho. Quase sempre a solução é deixar o banco fazer o trabalho que ele faz melhor que o Python: JOIN, contagem, soma, restrições e transações.